
Criei o OAEF depois de meses fazendo o DietAgent com agentes de IA. O agente escrevia código rápido, mas toda sessão começava do zero. Ele não lembrava o que a gente tinha decidido no dia anterior. E, quando não sabia alguma coisa, inventava.
Com humanos acontece parecido. Quem chega num projeto passa dias perguntando por que as coisas são do jeito que são. A resposta quase nunca está escrita. Quando está, fica num lugar que ninguém lembra de abrir.
O OAEF resolve as duas coisas no mesmo lugar: o próprio repositório. É open source, com licença Apache 2.0. O código está no GitHub .
Tudo que o projeto sabe fica no repositório
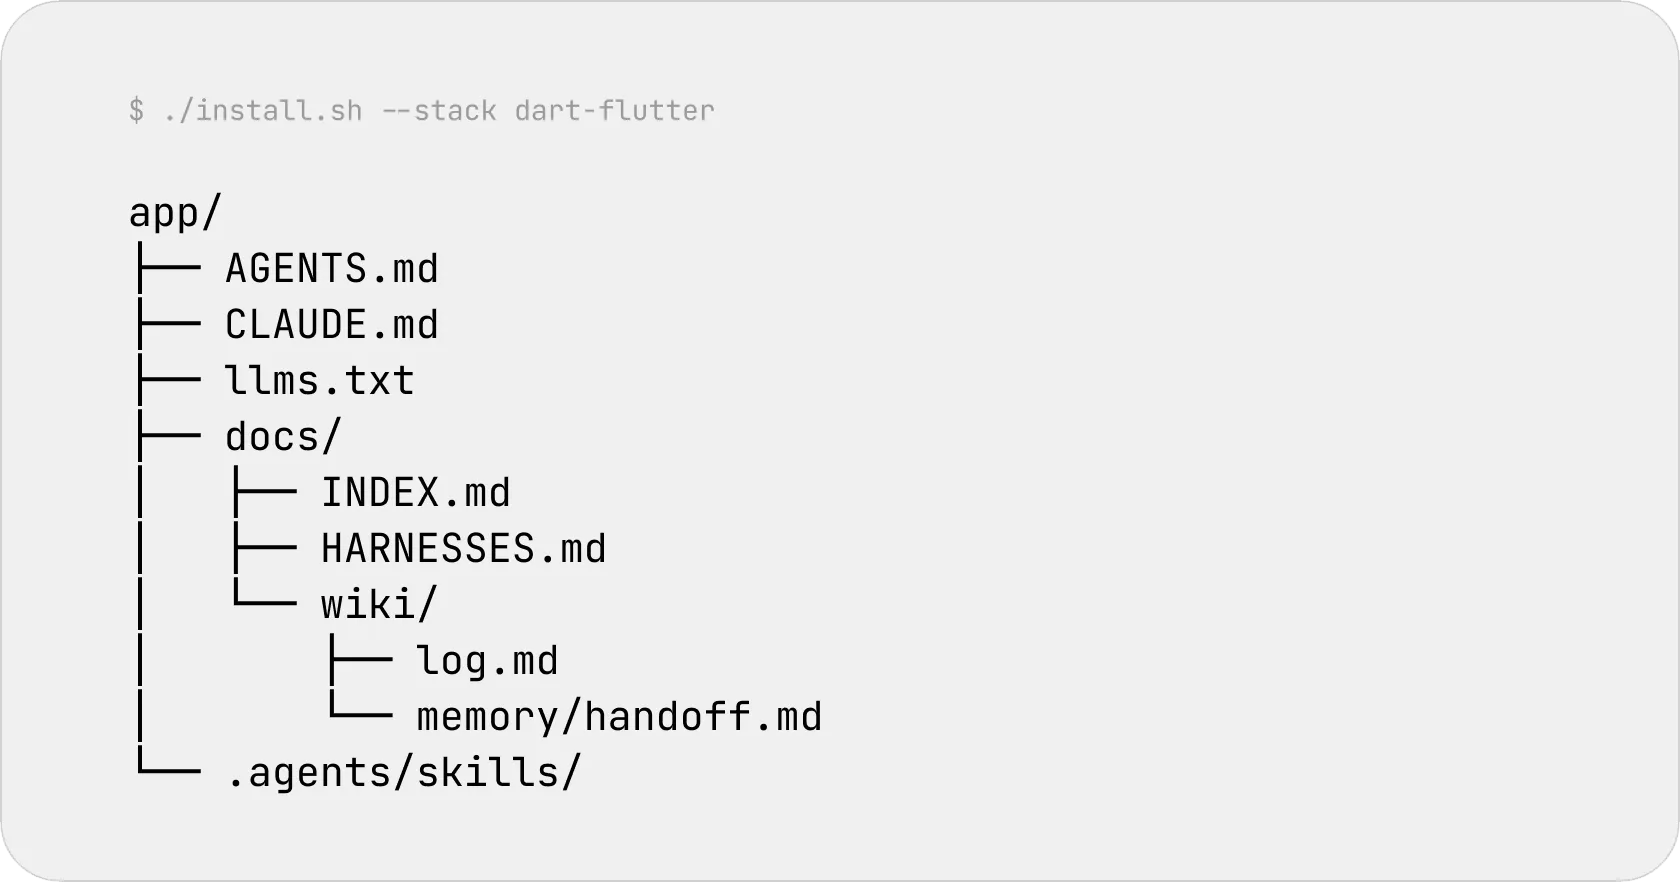
No DietAgent, comecei a escrever tudo dentro do repositório. As regras ficavam num arquivo que todo agente lê primeiro, o AGENTS.md. A spec do app e um doc pra cada área moravam ao lado do código. E, no fim de cada sessão, o agente deixava um bilhete pra próxima: o que mudou, por quê, o que ficou pendente e como conferir.
Deu tão certo que quis levar pros meus outros projetos. O OAEF é esse jeito de trabalhar, empacotado. Quando entra num projeto, ele cria o contrato dos agentes, as pastas de specs e de decisões, a memória entre sessões e um índice dos documentos.
O índice é a peça que mais uso. Ele diz qual documento ler pra cada tarefa. Em vez de abrir a pasta inteira, o agente lê só o que precisa, e o contexto fica livre pro que importa.
A memória fica em dois arquivos de texto comuns, versionados junto com o código. Um guarda o bilhete da última sessão. O outro é um diário que só cresce. Não precisa de banco vetorial nem de container.
A ordem de confiança
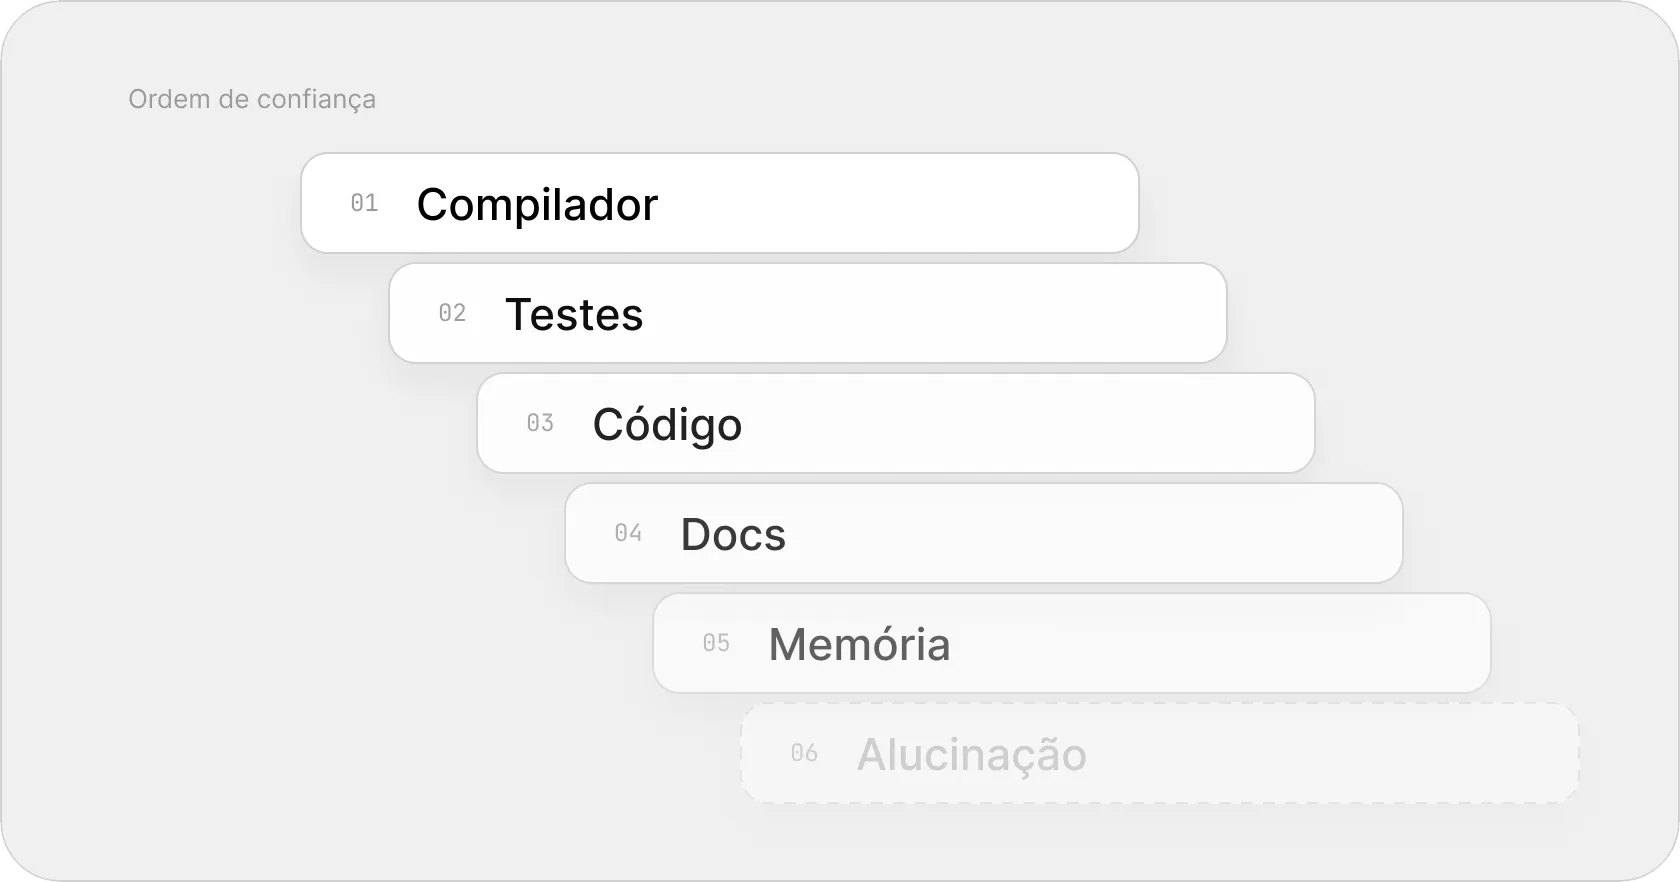
Num projeto feito com agentes, as fontes vivem discordando. A documentação diz uma coisa, o código faz outra, e o agente acredita no que leu por último. Por isso o OAEF tem uma regra pra decidir quem ganha.
O compilador vale mais que os testes. Os testes valem mais que o código. O código vale mais que a documentação, que vale mais que a memória. Lá embaixo fica a alucinação, que não vale nada.
Na prática, isso encerra muita discussão. Se a documentação diz uma coisa e o compilador recusa, a documentação está errada. Se o código compila e um teste quebra, o código está errado. E o agente não pode chutar o que o compilador ou os testes conseguem provar.
Escrito assim, parece óbvio. Só que é bem o tipo de coisa que um agente esquece no meio de uma sessão longa, quando já leu muito e começa a confiar no que ele mesmo escreveu.
O mesmo contrato pra todo agente
Cada ferramenta de agente procura as instruções num lugar. Umas leem o AGENTS.md direto, outras têm uma pasta própria. O OAEF mantém um contrato só e gera as cópias que cada ferramenta espera, sempre iguais ao original. Hoje funciona com mais de 20 ferramentas de agente.
Ele também se adapta à stack. São 12, de Flutter e Swift a Go, Rust e .NET, cada uma com os comandos de teste e de análise que ela já usa. Junto vêm as skills, instruções prontas pra tarefas comuns, como montar uma tela ou revisar o código antes do PR.
E tem as checagens que rodam sem ninguém precisar lembrar. A cobertura de testes tem um mínimo, e arquivo e função têm tamanho máximo. A régua só sobe: se a cobertura chegou num número, ela não pode cair depois.
Projeto que já existe
Quase ninguém começa do zero, então o OAEF entra em repositório antigo sem reescrever o que já está lá. Antes de mexer em qualquer arquivo, dá pra rodar uma simulação que só mostra o que ele faria:
oaef init --target . --stack auto --legacy --dry-runNa adoção, quase todas as regras novas começam só avisando, sem travar o build. A cobertura que o projeto já tem vira o piso, e daí pra frente ela só pode subir.
O que aprendi
Agente bom com contexto ruim faz estrago rápido. Quando o repositório explica as regras do projeto e o que aconteceu na última sessão, o agente para de adivinhar e passa a seguir o que está escrito.
Quem mais aproveita isso sou eu mesmo. Quando volto pra um projeto depois de uns dias longe, está tudo lá, até o motivo de cada decisão.